多代理協作機制與測試結果
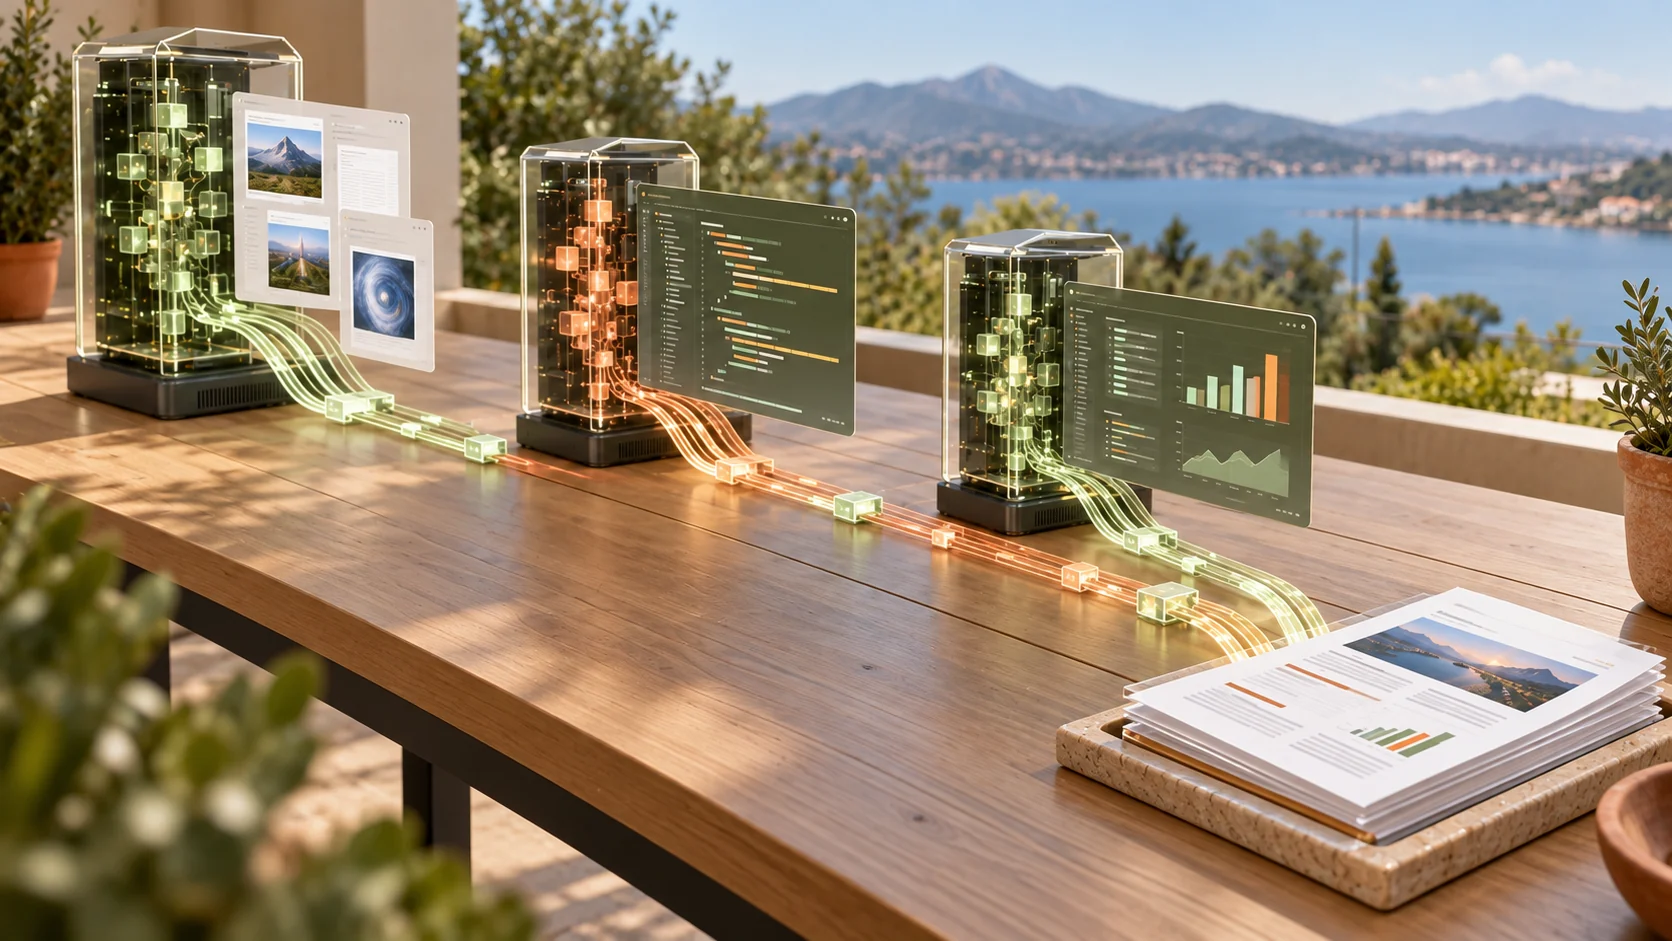
該實驗採用名為 Memdoor 的工作流,將五個 Qwen3.8-27B 模型分配為規劃者、兩個構想者、解決者和管理者,外加一個修復工作者。每個代理從全新的上下文開始,僅透過磁碟上的檔案進行溝通,不依賴聊天記錄。
在 LiveCodeBench Hard 的前十道題目上,每題執行五次並使用隱藏測試評分,該工作流的平均通過率為 9.8/10。相比之下,原論文作者的 harness 得分為 9.6/10,而 Fable 5 單次調用的得分為 8.0/10。
值得注意的是,在僅十題的小樣本中,9.8 與 9.6 的差異在統計上幾乎相同。此結果主要驗證了該工作流能重現原論文作者 harness 相對於 Fable 5 的效能優勢,而非證明其具有顯著的額外增益。
測試限制與潛在偏差
測試僅涵蓋十道題目且每題執行五次,遠少於原論文的 100 題規模。此外,這些競賽題目源自 2025 年春季,模型可能在訓練資料中已見過這些題目,因此無法排除數據污染的可能性。
Fable 5 的數據來自原論文檔案中的單次調用結果,並非在本次測試環境中重新執行。原論文作者的全量 100 題數據顯示,其 harness 得分為 92.4%,而 Fable 5 為 90.4%。
評估過程僅讓模型看到公開樣本,最終評分則基於隱藏測試。所有模型均在 OpenRouter 平台上運行,而非本地機器。
執行成本與失敗案例分析
每次執行的中位數時間為 40 分鐘,成本約 0.39 美元;50 次執行的總成本為 35.79 美元。所有請求、回覆、程式碼及評分輸出均已記錄在案。
在唯一失敗的題目上,管理者模型發明了錯誤的反例,導致團隊重寫了原本正確的程式碼。另有兩次情況中,正確的程式碼被覆蓋後又被恢復。這些問題均源自原論文作者的循環邏輯,在本次測試中保持原樣未作修改。
工作流架構與技術實作
該工作流由八個 YAML 檔案定義,無需編寫程式碼且未指定特定模型名稱。流程包括規劃、並行構想、解決、測試、審查、修復和驗證等步驟。每個代理的提示詞均強調「從全新上下文開始,讀取檔案,不依賴聊天」。
論文指出,這種基於檔案系統的嚴格紀律是效能提升的關鍵。每個步驟對應一個 YAML 檔案,定義了輸入輸出及依賴關係。若需更換角色行為,只需修改 steps/ 目錄下的提示詞即可。
社群觀點與本地化應用潛力
部分開發者認為,讓本地模型保持競爭力對於避免過度依賴大型雲端服務商至關重要。有評論指出,27B 參數的模型可在配備 64GB RAM 或 VRAM 的现代 PC 上運行,結合多代理架構可能實現接近大型模型的編碼能力。
然而,也有觀點提醒,構建能提升單一評估指標的 harness 相對容易,但要使其具備泛化能力則非常困難。此外,本地模型受限於上下文長度(如 256k),可能需要頻繁進行上下文壓縮,影響連續工作體驗。